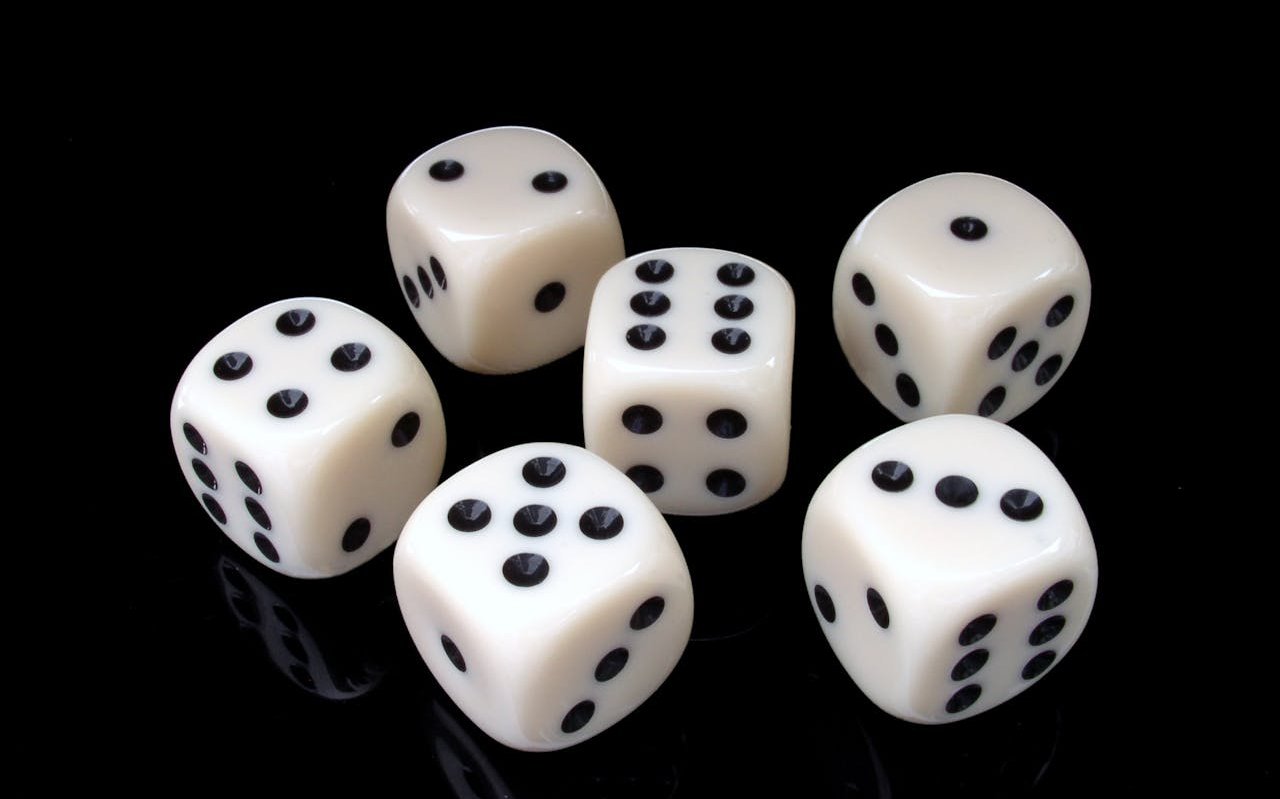
Peut-on concevoir un QCM qui mesure les compétences des candidats sans accorder une place excessive au hasard ? À partir d’une analogie avec le lancer de dés, nous examinons les probabilités de réussite aléatoire, le nombre de propositions de réponse, la multiplication des observations et l’organisation des épreuves.
Nous montrons également pourquoi la réduction du hasard, aussi nécessaire soit-elle, ne suffit pas à garantir la fidélité des scores, la validité des interprétations ou la justesse d’un classement.
Peut-on concevoir un QCM équilibré qui reflète fidèlement les compétences d’un candidat sans accorder une place excessive au hasard ?
Dans la conception d’un questionnaire à choix multiple (QCM), plusieurs questions se posent : combien de propositions de réponse faut-il prévoir par item ? Combien d’items sont nécessaires pour évaluer une même micro-compétence ? Combien d’items doivent composer une épreuve ? Et dans quelle mesure les résultats permettent-ils de départager équitablement les candidats ?
Pour éclairer ces questions, partons d’une analogie mathématique simple : le lancer de dés. Nous verrons ce qu’elle permet de démontrer, mais aussi les limites de ce qu’on peut en déduire pour l’évaluation des compétences.
Probabilité du double six : un cas exemplaire
Lorsqu’on lance deux dés équilibrés et indépendants, la probabilité d’obtenir un double six est de :
Une seule des 36 combinaisons équiprobables produit ce résultat.
Si l’on répète l’expérience, la probabilité d’obtenir deux doubles six consécutifs est :
Ainsi, la probabilité de reproduire plusieurs fois un résultat particulier par pur hasard diminue rapidement, à condition que les lancers soient indépendants.
C’est cette idée que nous allons transposer aux QCM, avec une précaution essentielle : les réponses à des items d’évaluation ne sont pas nécessairement comparables à des lancers de dés indépendants.
Combien de propositions de réponse dans un QCM ?
Dans un QCM comportant une seule réponse correcte parmi quatre propositions, un candidat qui choisit totalement au hasard possède une probabilité de réussite de 1/4, soit 25 %.
Avec cinq propositions, cette probabilité passe à 1/5, soit 20 %. Avec trois propositions, elle atteint 1/3, soit environ 33,3 %.
On pourrait donc être tenté d’augmenter systématiquement le nombre de propositions afin de réduire les chances de réussite aléatoire. Ce raisonnement serait toutefois incomplet.
En effet, les propositions incorrectes – les distracteurs – doivent être plausibles pour les candidats auxquels s’adresse l’épreuve. Ajouter des distracteurs artificiels, manifestement erronés ou peu crédibles détériore généralement la qualité de l’item.
La méta-analyse de Rodriguez (2005) montre ainsi que les QCM à trois propositions constituent souvent une solution efficace : à durée de passation comparable, ils permettent de proposer davantage d’items et de mieux couvrir le domaine évalué, sans nécessairement dégrader les propriétés psychométriques des scores.
Le choix entre trois, quatre ou cinq propositions doit donc dépendre de la qualité des distracteurs, de l’objectif de l’évaluation, de la population concernée et du temps disponible.
Ce n’est pas le nombre de propositions qui fait, à lui seul, la qualité d’un QCM, mais la pertinence des choix proposés et leur contribution à la mesure recherchée.
Combien d’items pour évaluer une même micro-compétence ?
Dans une épreuve de FLE, les items peuvent porter, par exemple, sur la compréhension globale d’un document, le repérage d’informations spécifiques, les relations logiques ou certaines connaissances linguistiques.
Lorsqu’une micro-compétence n’est évaluée qu’au moyen d’un seul item, la réponse observée constitue une information limitée. Elle peut dépendre d’une connaissance ponctuelle, d’une interprétation particulière de la consigne, d’une erreur d’inattention ou du hasard.
Multiplier les observations permet généralement de réduire le poids relatif de ces facteurs et d’obtenir une mesure plus stable, à condition que les items apportent des informations pertinentes et suffisamment distinctes.
Pour la construction d’activités pédagogiques, prévoir trois à cinq items ciblant une même micro-compétence peut constituer un choix pratique raisonnable. Il ne s’agit toutefois pas d’un minimum universellement établi par la théorie des tests.
Le nombre d’items nécessaire dépend notamment de leur difficulté, de leur pouvoir discriminant, de leurs interdépendances, de l’hétérogénéité des candidats et de la précision souhaitée.
Il importe également de distinguer le nombre d’items d’une activité du nombre total d’observations mobilisées pour interpréter la maîtrise d’une compétence.
Une multiplication d’items mal conçus n’améliore pas nécessairement la mesure. Ce qui compte, c’est l’information pertinente apportée par l’ensemble des réponses.
Combien d’items dans un examen QCM ?
Reprenons notre raisonnement probabiliste.
Supposons qu’un examen comporte 30 items indépendants, proposant chacun quatre réponses équiprobables dont une seule est correcte. Un candidat répond entièrement au hasard.
Le nombre de bonnes réponses suit alors une loi binomiale de paramètres n = 30 et p = 0,25.
La probabilité qu’il réponde correctement à au moins 15 questions est :
Soit environ 0,275 %.
Si le seuil de réussite est fixé à 18 bonnes réponses :
Soit environ 0,005 %.
Ces résultats sont éloquents : sous les hypothèses retenues, un candidat répondant intégralement au hasard possède une probabilité très faible d’atteindre ces seuils.
Peut-on en conclure que tout candidat qui les atteint possède nécessairement les compétences évaluées ?
Non. Les probabilités calculées permettent seulement d’apprécier la rareté de ces résultats dans le modèle du choix entièrement aléatoire. Elles ne prouvent ni la maîtrise effective de la compétence, ni la qualité des items, ni la validité de l’épreuve.
De plus, un candidat réel ne répond pas nécessairement au hasard à toutes les questions. Il peut reconnaître certaines réponses, éliminer des distracteurs, mobiliser des connaissances partielles ou exploiter des indices involontairement fournis par le test.
Enfin, rien ne permet de fixer à 30 items un seuil universel garantissant la fidélité d’une épreuve. Le nombre nécessaire doit être déterminé en fonction des objectifs, des propriétés des items et de la précision recherchée.
Une faible probabilité de réussite par hasard est une propriété souhaitable, mais elle ne constitue pas une preuve suffisante de la qualité d’un examen.
Nombre d’activités et structuration d’une épreuve
Une épreuve ne devrait pas se réduire à une accumulation d’items. Sa conception suppose une réflexion préalable sur le domaine à évaluer, les compétences visées et les interprétations auxquelles les résultats doivent donner lieu.
Dans une évaluation en langue étrangère, on peut organiser les items en activités cohérentes portant, par exemple, sur différents aspects de la compréhension orale ou écrite, sur des opérations de traitement de l’information ou sur des connaissances linguistiques déterminées.
Une telle organisation facilite la couverture des objectifs retenus et la lisibilité du dispositif.
Elle permet également de diversifier les documents, les situations et les opérations sollicitées, à condition d’éviter les redondances inutiles et les dépendances excessives entre items.
Une épreuve composée de 30 à 50 items peut ainsi représenter une solution pratique dans certains contextes. Cette fourchette ne constitue cependant ni une obligation méthodologique ni une garantie de fidélité.
La conception doit d’abord reposer sur une table de spécification précisant les contenus, les opérations attendues, le nombre d’observations souhaité et le poids accordé aux différentes composantes.
La fidélité des scores et la précision de mesure doivent ensuite, autant que possible, être examinées empiriquement.
Quel format retenir pour un examen QCM ?
Pour des raisons pratiques et pédagogiques, on peut envisager une épreuve comportant plusieurs activités, chacune constituée d’environ cinq items proposant trois ou quatre réponses, dont une seule est correcte.

À titre d’exemple, une structure de 20 activités de 5 items à 4 propositions conduit à un total de 100 items.
Ce format 20 × 5 × 4 peut présenter plusieurs avantages : diversification des situations, organisation lisible de l’épreuve, couverture relativement étendue du domaine évalué et multiplication des observations.
Il ne s’agit cependant pas d’un format optimal au sens psychométrique, indépendamment du contexte.
Sa pertinence doit être appréciée en fonction des contraintes de durée, de la population évaluée, du niveau de compétence, de la nature des tâches et des données recueillies lors de l’expérimentation des items.
Dans les activités d’appariement ou de distribution, il peut être utile d’ajouter une réponse non appariée, parfois appelée « réponse leurre ».
Cette précaution limite certaines déductions mécaniques par élimination, notamment lorsque toutes les autres réponses ont déjà été utilisées. Elle ne supprime cependant pas toutes les dépendances entre les réponses et ne garantit pas, à elle seule, la fidélité ou la validité de l’activité.
Une activité d’appariement ne peut d’ailleurs pas être assimilée sans précaution à une succession d’items indépendants : les choix effectués peuvent modifier les possibilités restantes.
Effet du hasard sur le classement dans un concours
Dans un concours, la question ne consiste pas seulement à déterminer si un candidat peut réussir par hasard. Il faut aussi examiner dans quelle mesure les scores permettent de départager les candidats avec une précision suffisante.
Considérons une épreuve de 100 items indépendants comportant chacun quatre propositions, dont une seule est correcte.
Un candidat répondant intégralement au hasard obtiendrait en moyenne :
Soit 25 bonnes réponses sur 100.
L’écart-type de cette distribution binomiale est :
En utilisant une approximation normale, environ 95 % des scores issus de réponses entièrement aléatoires se situeraient entre :
Soit, approximativement, entre 16 et 34 bonnes réponses.
Cette distribution décrit les scores que produirait une stratégie de réponse entièrement aléatoire.
Elle ne décrit toutefois pas directement les erreurs de classement des candidats réels.
En effet, ces derniers possèdent des niveaux de compétence variables, répondent à certains items avec plus ou moins de certitude et ne présentent pas tous les mêmes probabilités de réussite.
Pour apprécier le risque d’un classement erroné, il faut s’intéresser à la précision des scores et à leur erreur de mesure, en particulier lorsque plusieurs candidats obtiennent des résultats proches.
Deux candidats séparés par un seul point ne présentent pas nécessairement une différence de compétence suffisamment importante pour que leur ordre de classement soit considéré comme certain.
Discrimination des items, fidélité et précision du classement
Le pouvoir discriminant d’un item renseigne sur sa capacité à différencier les candidats selon la dimension évaluée. Un item bien discriminant tend à être réussi plus fréquemment par les candidats possédant davantage l’ensemble des performances mesurées.
Il contribue ainsi à la qualité de la mesure, à condition que la discrimination observée porte bien sur la compétence visée et non sur une caractéristique étrangère à celle-ci.
Cependant, une forte dispersion des scores ne suffit pas à garantir un classement juste. Une épreuve peut différencier nettement les candidats dans leur ensemble tout en restant peu précise pour départager ceux dont les résultats sont voisins.
La fidélité des scores, l’erreur standard de mesure et, lorsque les enjeux le justifient, la cohérence des décisions de classement constituent donc des éléments essentiels de l’analyse.
Il convient également de vérifier que les items ne favorisent ou ne désavantagent pas certains groupes de candidats pour des raisons sans rapport avec la compétence évaluée.
Les Standards for Educational and Psychological Testing (AERA, APA & NCME, 2014) soulignent précisément la nécessité de réunir des preuves adaptées à l’usage prévu des scores et aux conséquences des décisions prises.
Réduire le hasard, assurer la fidélité, établir la validité : trois exigences distinctes
Notre analogie avec les dés permet finalement de mettre en évidence trois problèmes qu’il importe de ne pas confondre.
- Réduire les effets du hasard consiste notamment à limiter le poids des réponses aléatoires dans les résultats. Le nombre de propositions, la qualité des distracteurs et la multiplication des observations peuvent y contribuer.
- Assurer la fidélité des scores suppose d’examiner leur précision et leur stabilité dans les conditions de mesure définies. Cette exigence ne découle pas automatiquement d’un nombre élevé d’items.
- Établir la validité des interprétations et des usages nécessite de montrer que les résultats permettent effectivement de soutenir les conclusions et les décisions envisagées à propos des compétences des candidats.
Ces trois exigences sont liées, mais elles ne se substituent pas les unes aux autres.
Un examen peut présenter une probabilité extrêmement faible de réussite par pur hasard tout en mesurant imparfaitement les compétences qu’il prétend évaluer.
À l’inverse, un instrument soigneusement construit, expérimenté et analysé peut fournir des informations pertinentes à partir d’un nombre relativement limité d’items, selon l’objectif poursuivi.
Conclusion
L’analogie entre le lancer de dés et les réponses à un QCM éclaire utilement la place du hasard dans l’évaluation. Elle montre notamment pourquoi la répétition d’observations suffisamment indépendantes réduit la probabilité qu’une réussite élevée résulte d’une succession de choix aléatoires.
Elle nous invite également à distinguer ce que les probabilités permettent effectivement de démontrer de ce qui relève de la qualité psychométrique d’une épreuve.
Ni le nombre de propositions de réponse, ni celui des items, ni leur répartition en activités ne permettent, isolément, de garantir la fidélité des scores ou la validité de leur interprétation.
Une évaluation rigoureuse résulte d’un ensemble de choix cohérents : définition des compétences visées, spécification des contenus, rédaction d’items pertinents, analyse de leur fonctionnement, estimation de la précision des scores et examen des conséquences des décisions.
Dans un concours, où quelques points peuvent déterminer une admission ou un rejet, ces exigences deviennent particulièrement importantes.
En définitive, la qualité d’un QCM ne tient pas seulement à sa capacité de réduire les effets du hasard, mais surtout à celle de fournir des informations suffisamment pertinentes et précises pour soutenir des décisions justifiées.
Références bibliographiques
American Educational Research Association, American Psychological Association, & National Council on Measurement in Education. (2014). Standards for educational and psychological testing. American Educational Research Association. https://www.testingstandards.net/open-access-files.html
Delhaye, O. (2023). Évaluation des savoirs et des compétences de communication en langue étrangère [Matériel de cours]. Université Aristote de Thessalonique.
Laveault, D., & Grégoire, J. (2014). Introduction aux théories des tests en psychologie et en sciences de l’éducation. De Boeck.
Rocher, T. (2015). Méthodes psychométriques utilisées dans le cadre des évaluations des élèves. Éducation & formations, (86–87), 37–57.
Rodriguez, M. C. (2005). Three options are optimal for multiple-choice items : A meta-analysis of 80 years of research. Educational Measurement : Issues and Practice, 24(2), 3–13. https://doi.org/10.1111/j.1745-3992.2005.00006.x
Professionnel de l’enseignement supérieur et de la recherche depuis plus de trente-cinq ans, ancré en linguistique et en didactique des langues, avec une spécialisation en méthodologie de l’enseignement-apprentissage, en évaluation des compétences en langues et en pédagogie numérique.
Lien vers Page perso